Databricks AI Index 是什么?
Databricks AI Index 是结合匿名化企业 AI 使用与支出数据、并按周更新编程智能体评测的公共资源。本文说明它发布哪些数据、如何衡量成本与质量。
最近更新 ·
Databricks AI Index:企业 AI 采用、支出与编程智能体基准
资料对应公告日期:
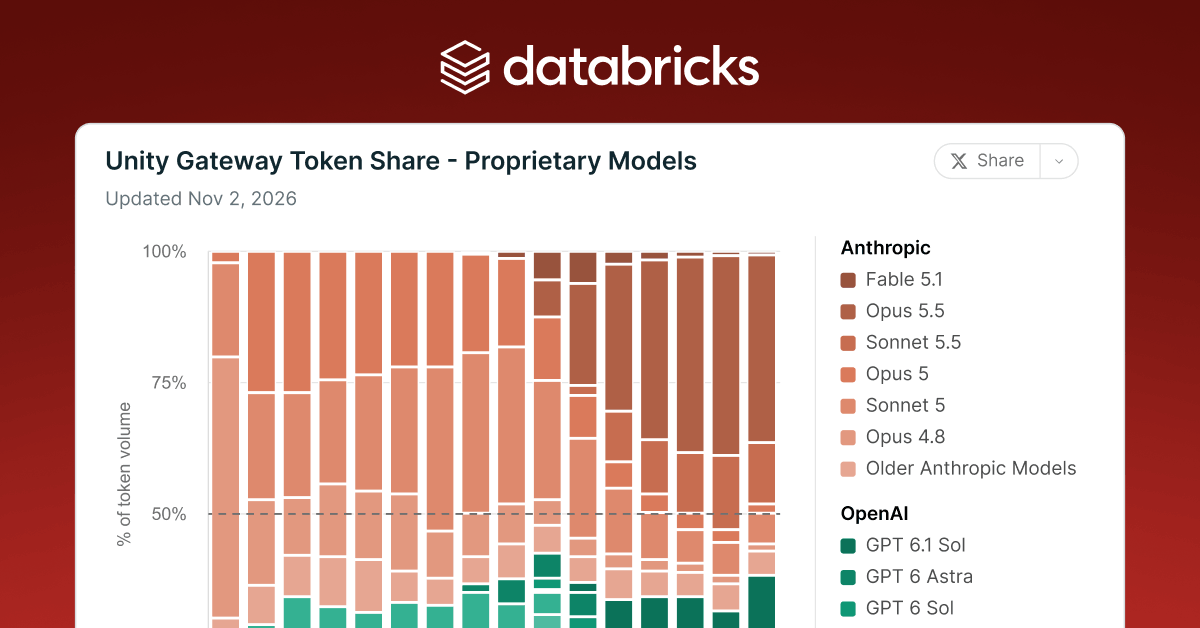
Databricks AI Index 是 Databricks 推出的公共资源,把聚合、匿名化的企业 AI 使用与支出数据,与长期公开的编程智能体评测套件放在一起。它关注企业在真实场景中如何使用模型:使用多少家供应商、开源权重模型占多少流量,以及哪些“模型 + 智能体框架”组合在任务成功率和单任务成本之间取得最佳平衡。当前数据集覆盖 2026 年 9 月 21 日至 11 月 7 日,基准部分会随新模型发布按周更新。
Databricks AI Index 是什么
Databricks AI Index 是 Databricks 推出的公共资源,将企业 AI 使用与支出洞察同编程智能体评测集中呈现。它不是一份一次性报告,而是持续更新的索引:使用数据随底层流量变化而刷新,评测套件长期公开,并随新的专有模型和开源权重模型发布按周更新。
使用侧数据来自 10,000 多家使用 Unity Gateway 的企业的聚合、匿名化数据,覆盖数字原生公司、财富 500 强和全球 2000 强企业。由于 Unity Gateway 也会把流量路由到 Anthropic、OpenAI 等外部供应商,该指数能反映多供应商行为,而不只是 Databricks 托管的模型。
- 公共资源,结合企业 AI 使用与支出数据以及编程智能体评测
- 包含长期公开的内部评测套件,按周更新
- 使用数据来自 10,000 多家 Unity Gateway 企业,含外部供应商流量
指数发布哪些数据
指数发布两大类信息。第一类是企业采用与支出:企业使用哪些模型供应商、使用集中还是分散,以及 token 流量在专有模型与开源权重模型之间如何分配。模型支出按供应商公开标价估算,而非按实际合同价格。
第二类是编程智能体表现。基准以任务成功率和单任务完成成本比较“模型 + 智能体框架”组合,因此读者不仅能看到哪个模型能力最强,还能看到哪些组合位于成本-质量前沿。Databricks 也说明,结果反映的是所评测的工作负载和模型,不同组织之间可能存在差异。
- 采用指标:每家企业的模型供应商数量与供应商构成
- 开源权重模型与专有模型的 token 流量占比
- 基于供应商公开标价估算的模型支出
- 编程智能体任务成功率与单任务完成成本
更新频率与数据覆盖范围
当前数据集覆盖 2026 年 9 月 21 日至 11 月 7 日。评测套件会随新的专有模型和开源权重模型发布按周更新,因此该指数是持续变化的快照,而不是固定的年度研究。
由于时间窗口较短,指数更适合作为判断企业行为快速变化的方向性信号。跨版本比较有助于发现供应商多元化和开源权重采用的变化,但底层工作负载和模型阵容本身也在变化。
- 当前数据窗口:2026 年 9 月 21 日至 11 月 7 日
- 基准评测随新模型发布按周刷新
- 支出数字为公开标价估算,并非实际账单金额
如何衡量编程智能体的表现与成本
编程智能体评测基于 Databricks 工程师真实使用的编程智能体工作流,并通过 Unity Gateway 采集。这些工作流涵盖创建和审查拉取请求、排查问题以及处理复杂开发任务,因此基准反映的是生产式工作,而非孤立的题目。
为降低基准污染风险,任务来自 Databricks 的私有代码库和未公开测试。结果依据隐藏测试而非 LLM 评审打分,并以“模型 + 智能体框架”组合(例如使用 Claude Code 和 Codex)在任务成功率和单任务完成成本上进行比较。最新基准评测覆盖九家 AI 实验室的模型。
- 任务来自真实工程工作流:PR 创建与审查、问题排查、复杂开发
- 私有代码库与未公开测试降低污染风险
- 依据隐藏测试评分,而非 LLM 评审
- 按任务成功率和单任务完成成本比较不同模型与框架组合
多模型与开源权重采用的主要发现
最显著的采用信号是多元化。就在 7 月,使用 Unity Gateway 的企业中约 64% 只依赖一家模型供应商;到 11 月 2 日,这一比例降至 28%,更多组织开始采用两家或更多供应商的模型。
开源权重模型呈现类似趋势。其企业 token 流量占比从 7 月的 7.3% 升至 11 月的 30.9%,不到四个月增长超过四倍。在编程质量基准中,有三款开源权重模型进入前十,其中 DeepSeek V4.1 和 GLM 5.3 以 93.1% 的通过率并列第三。在最新编程智能体基准中,来自 OpenAI、DeepSeek、Meta 和 Anthropic 四家实验室的五款模型位于成本-质量前沿。
- 单一供应商企业占比从 7 月约 64% 降至 11 月 2 日的 28%
- 开源权重模型的企业 token 流量占比从 7 月 7.3% 升至 11 月 30.9%
- 三款开源权重模型进入编程质量前十,DeepSeek V4.1 与 GLM 5.3 以 93.1% 并列第三
- 最新编程智能体基准中,四家实验室的五款模型位于成本-质量前沿
如何在实际工作中使用该指数
在决定如何组织模型访问方式时,该指数可作为参考。如果你的组织仍依赖单一供应商,多元化趋势提示你应针对自身工作负载测试第二个模型系列,而不是假设指数排名可以直接迁移。
对编程智能体而言,成本-质量框架比单一榜单名次更重要。应同时比较任务成功率和单任务完成成本,并把公开结果当作待验证的假设,用自有代码库和审查流程加以检验。另需注意,支出数字是按公开标价估算的,企业协议下的实际计费可能不同。
- 用多元化数据支持测试第二家供应商
- 评估编程智能体时同时看单任务完成成本,而非只看成功率
- 用自有代码库和审查流程验证公开排名
- 把支出数字视为标价估算,而非账单
常见问题
Databricks AI Index 是什么,会发布哪些数据?
它是 Databricks 的公共资源,结合企业 AI 使用与支出数据以及编程智能体评测。发布内容包括每家企业的模型供应商数量、开源权重与专有模型的 token 流量占比、基于公开标价估算的模型支出,以及编程智能体任务成功率和单任务完成成本。
Databricks AI Index 多久更新一次,当前数据集覆盖哪个时间段?
评测套件会随新的专有模型和开源权重模型发布按周更新。当前数据集覆盖 2026 年 9 月 21 日至 11 月 7 日。
Databricks AI Index 如何衡量编程智能体的表现与成本?
它使用通过 Unity Gateway 采集的 Databricks 工程师真实编程智能体工作流,涵盖拉取请求创建与审查、问题排查和复杂开发任务。任务来自私有代码库和未公开测试,依据隐藏测试而非 LLM 评审评分,并按任务成功率和单任务完成成本比较模型与框架组合。
指数显示企业在多模型采用和开源权重模型使用方面有哪些变化?
只依赖一家模型供应商的企业占比从 7 月约 64% 降至 11 月 2 日的 28%。开源权重模型的企业 token 流量占比从 7 月 7.3% 升至 11 月 30.9%,且有三款开源权重模型进入编程质量前十。
原始资料
工具信息
工具信息有变化? 帮助我们更新
Databricks AI Index 的评价
正在加载评价…